做过 RAG 的人,大概率都知道这套流程:
文档切片 → Embedding → 向量数据库 → 相似度检索 → 交给大模型生成答案。
但真正的问题是:一段文字为什么能变成向量?两个向量凭什么能判断“语义相似”?几十万甚至上百万条数据,又是怎么快速找到最相关内容的?
这几个问题,才是理解 RAG 向量检索的关键。
#一、Embedding:一段文字,怎么变成一串数字
把文本变成数字的过程,干这件事的模型叫嵌入模型(embeddings model,也叫向量模型)。它只做一件事:文本进去,一串固定长度的数字出来,这串数字就是向量。在检索这条链上,单位是切好的块,一个块压出一个向量。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("BAAI/bge-small-zh-v1.5")
vecs = model.encode(["这个多少钱", "公司考勤制度规定员工上下班需打卡"])
print(vecs.shape)
# (2, 512):一句五个字、一句十七个字,压出来都是 512 个数字
512 就是维度:每个数字代表向量在某个方向上的分量,长度由模型决定,不随输入变化。有的模型还能在请求里指定输出多少维,默认 1024,改成 64 也能跑,只是能用来说清意思的方向变少了。不同模型压出来的是各自独立的一套坐标,不能混着比,中途换一次嵌入模型,等于库里的向量全部作废。
那它凭什么能把“意思”翻准?意思相近的文本,压出来的坐标也挨得近。
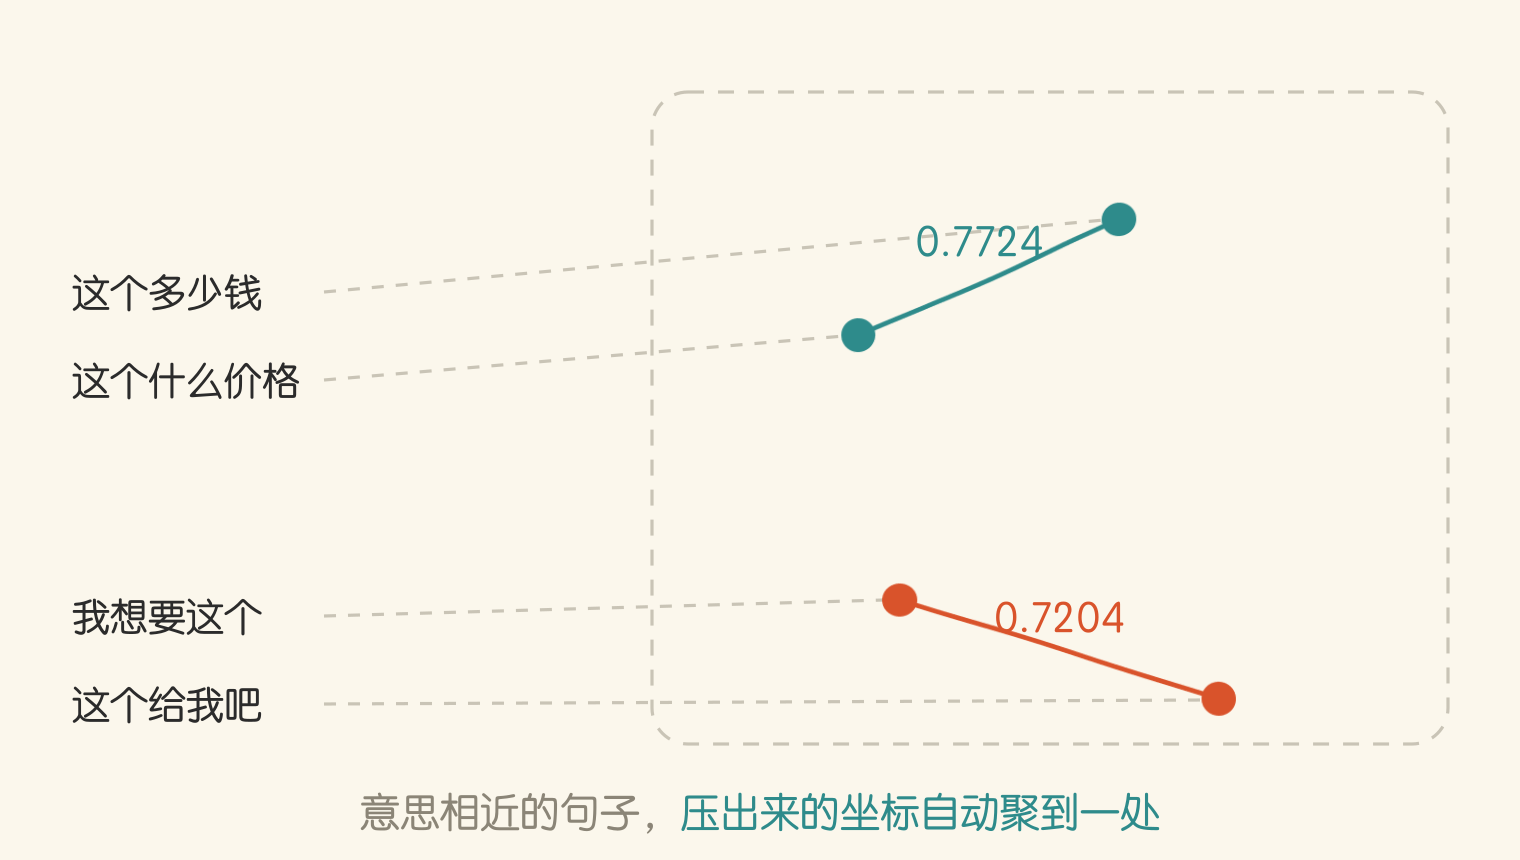
比如有这样一段文本,里面混着两种意思:两句在问价钱(“这个多少钱”“这个什么价格”),两句在表达想要(“我想要这个”“这个给我吧”)。各压成一个向量、两两算一遍相似度:问价的两句 0.7724,想要的两句 0.7204,跨过这两组掉到 0.5255。没有人告诉过模型谁和谁是一类。
#二、相似度算法:两个向量,怎么判断有多像
坐标挨得近就相似,这是嵌入模型给的;但到底有多像,得拿两串数字自己算。常用的算法有三种。
- 余弦相似度(Cosine):看两个向量的夹角,同向是 1,垂直是 0,反向是 −1,越大越像。
- 欧氏距离(L2):看两个点之间的直线距离,越小越像。
- 点积:两个向量对应位置相乘再相加,越大越像,它把长度一起乘了进去。
import numpy as np
from numpy import dot
from numpy.linalg import norm

def cos_sim(a, b):
    """余弦相似度:越大越像"""
    return dot(a, b) / (norm(a) * norm(b))

def l2(a, b):
    """欧氏距离:越小越像"""
return norm(np.asarray(a) - np.asarray(b))这三种不是同一件事换了三种写法。它们真的会给出不同的答案。拿一个问题和五个候选块算一遍:
| 候选块 | 余弦 ↑ | 欧氏距离 ↓ | 点积 ↑ |
|---|---|---|---|
| d1 和问题同方向,只是长一倍 | +1.0000 | 3.7417 | 28.0000 |
| d2 方向最接近,长短相当 | +0.9972 | 0.2828 | 13.8000 |
| d3 另一个方向 | +0.4226 | 3.7417 | 5.0000 |
| d4 内容很长,方向一般 | +0.9258 | 13.9284 | 60.0000 |
| d5 方向相反 | −1.0000 | 7.4833 | −14.0000 |
五个向量都是三维的,问题是 [1, 2, 3],候选块依次是 [2, 4, 6]、[1, 2.2, 2.8]、[3, 1, 0]、[10, 10, 10]、[-1, -2, -3],可以自己代进去复算。
三个算法选出三个不同的第一名:余弦选 d1(1.0000,和问题方向完全一致);欧氏距离选 d2(0.2828),余弦给满分的 d1 退到第二档,距离和另一个方向的 d3 一模一样;点积选 d4(60.0000),一个方向平庸、只是特别长的块。
这不是算错,是三种算法量的不是同一件事:余弦把长度约掉了(除以两个模长),只看方向;欧氏距离同时吃方向和长度;点积连约都不约,长度直接乘进分数,文本越长分数越高。而块的长度天然不齐,问题通常还很短,用欧氏距离或点积,你量到的其实是“长度差”,不完全是意思像不像。做文本检索第一反应通常是余弦,原因就在这里。
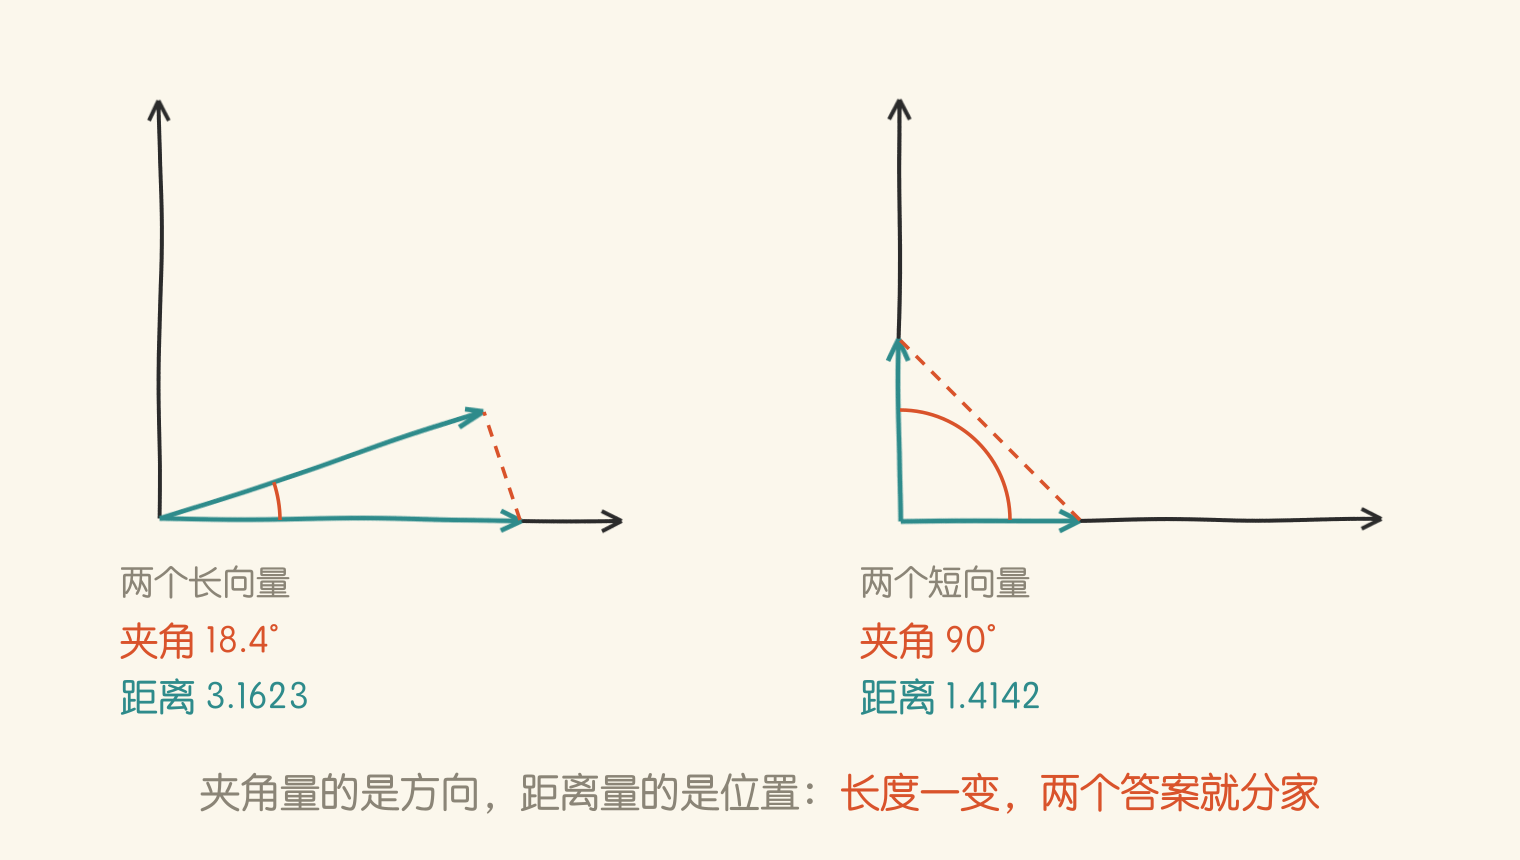
夹角和距离也不是一回事:
v1(10, 0) 与 v2(9, 3):夹角 18.4°、余弦 0.9487,距离 3.1623
v3(1, 0) 与 v4(0, 1):夹角 90°、余弦 0.0000,距离只有 1.4142
角度差了 70 多度的一对,距离反而更近。“离得近就相似”只在向量长度差不多的时候成立。 很多向量库入库前先把向量归一化,就是在统一长度,让三种算法给出同一个排序。
还有两点要记住。分数没有绝对刻度:1024 维里两段互不相关的文本,余弦基本落在 ±0.03 以内(标准差约等于 1 除以维度的平方根),所以“超过 0.6 才算相关”这类阈值别跨维度、跨模型照抄。拿一个向量和它自己比,余弦应该是 1、欧氏距离应该是 0,对不上就说明中间某一步出了问题。
#三、向量数据库:上百万条,怎么快速找到最像的
向量化跑完,库里只剩下坐标。几十万、上百万条坐标要存下来,还要在毫秒里把最像的几条捞出来,这件事交给向量数据库。它的定位跟普通数据库不一样:存储是次要的,查询才是重点。
难点就在这个“快”上。挨个比对是算不过来的,一百万条就是一百万次相似度计算。向量库的办法是给这些坐标建索引:按邻近关系把它们组织成一张可以抄近路的图,查找时只走其中一小段路径,不必碰全量。代价是捞出来的是近似最近邻,可能差一点点、不是全局最优,换来的是数量级的速度差。检索场景里,这笔买卖划算。
下边以 ChromaDB 为例,最常用的三个动作:
- 建集合:
collection就是一张表。chromadb.Client()存内存,进程一关就没了;chromadb.PersistentClient(path="./chroma_data")才落盘,路径选错,每次重启库都是空的。 - 写入:
collection.add(embeddings=..., documents=..., ids=...)。向量必须,原文可选,id 必须。 - 检索:
collection.query(query_embeddings=..., n_results=5)。传的是问题压出来的向量,不是问题的文字。
import chromadb

client = chromadb.PersistentClient(path="./chroma_data")
collection = client.get_or_create_collection(
    name="demo",
    metadata={"hnsw:space": "l2"},   # 距离度量:l2(默认) / cosine / ip
)

collection.add(
    embeddings=vecs,                  # 每个块的向量(必须),vecs 来自前面:切块后逐块压出来
    documents=chunks,                 # 每个块的原文(可选)
    ids=[f"id{i}" for i in range(len(chunks))],
)

# 检索:问题也得用同一个嵌入模型压成向量,不能直接传文字
q_vec = model.encode("这个多少钱")
results = collection.query(query_embeddings=[q_vec], n_results=5)
这段代码里最容易翻车的是 metadata={"hnsw:space": "l2"}:“距离度量”是配置项,可选 l2(默认)、cosine、ip,选哪个直接对应第二节那三种算法。默认的 l2 就是欧氏距离,也正是被证明“量到的其实是长度差”的那一个。随手用默认值,挑出来的“最像”就是另一块,不报错、不提示,只是结果悄悄不对。
另外一个容易踩的:各平台单次能传的分块个数不定,需要按平台和模型自己的规定设置;一次别把几百个块都塞进去,超了得自己按 batch_size 分批送。
选型上,下边这几款是具有代表性的数据库,怎么选:
| 数据库 | 开源 / 闭源 | 适合谁 |
|---|---|---|
| Chroma | 开源 | 轻量易用,LangChain 直接支持,适合中小项目和本地开发 |
| Faiss | 开源 | 批量搜索、向量量化,图像检索和推荐系统里用得多 |
| Milvus | 开源 | 毫秒级搜十亿级向量、支持分布式,企业应用较多 |
| Pinecone | 闭源 | 托管服务,自带去重、排名跟踪这些能力 |
| Redis | 开源 | 内存数据库,加上向量检索模块也能当向量库;已经在用 Redis 的团队不必再引一套存储 |
| PostgreSQL | 开源 | 关系数据库装上 pgvector 扩展就能存向量;数据本来就在 PG 里,省掉一套独立存储 |
本地开发通常从 Chroma 起步,等数据量和并发上来了,再考虑 Faiss 或 Milvus;如果团队本来就在跑 Redis 或 PostgreSQL,很多时候不必再引一套新存储,扩展现有的就够。 表里只是常见的一批,可选的不止这些;但不管用哪一款,前面那两条结论都成立:度量是配置项,分数没有绝对刻度。
#四、总结
回头看开头那三个问题:
一段文字为什么能变成向量:嵌入模型把它压成固定长度的一串数字,这就是向量;意思相近的,坐标就挨得近。模型换了,库里的向量全部作废。
两个向量凭什么能判断“语义相似”:靠算法量,余弦看方向,欧氏距离和点积把长度也算进去,选错一个,被挑出来的“最像”就是另一块。分数没有绝对刻度,只有放在同一批候选里比大小才有意义。
上百万条怎么快速找到最相关的:建索引、抄近路,用一点精确度换数量级的速度。
所以“RAG 答不准”,很多时候跟模型无关:是链路上某一环比错了,不是模型不够聪明。
你被相似度分数坑过吗:是阈值照着别人的抄的,还是换了模型没重建索引? 评论区聊聊,也给后面看到的人留个参考。
下一篇讲检索的进阶玩法:检索的单元,和喂给模型的单元,其实不必是同一个。